Post in evidenza

Covid-19 la nostra app è sempre attuale

  Con l'assidua collaborazione  Marco Mingione  e  Pierfrancesco Alaimo Di Loro  abbiamo creato uno strumento web interattivo che consen...

domenica 12 aprile 2020

So many words

StatGroup-19 was born on March 3, with Fabio's call to arms.
We could not stand still in the face of the starting epidemic, miraculous models that claimed to save Italy from Covid-19 (it seemed like a TV sale: "and with the model I also give you two pots and three pans!") and people's real need to understand what's going on.
On our side we have that we made our work  out of the  passion of a lifetime.
Navigate the stream of data, sometimes not clean data,
that are made public every day has been our job for years. Our motto is "get your hands dirty instead of watching".

Our common work is a continuous flow of thoughts, sometimes disconnected, often at 6 in the morning or at 2 in the morning (insomnia is one of the common denominators that keep us together). Everything takes place in a chaotic Facebook chat, tucked into our already chaotic daily life made up of the usual workload, including teaching and research. We asked ourselves then: what did  we say these days?


Below you can see a wordcloud of the most frequently used words in these forty days.
Yesterday there were 26116 messages and 138245 words, with which we understood a little
more of the covid-19 pandemic, we gave ourselves some answers, we shared our code with colleagues from ours and from other countries, and above all, we hope to have helped someone to rationalize and to be less afraid. Close to typical words of our discipline (data, model, poisson, exponential ..) emerges the urgency, the need to quickly understand, launch hypotheses, conjectures, and doubts and continually verify them on the data (credo, forse, sembra, capire, fare...- I think, perhaps, it seems, understand, do ...), the words today (oggi), do (fare), done (fatto9, so frequent indicate concreteness and work in real-time.


A childhood friend of one of us, a few weeks ago, wrote: "I don't understand what those red dots are that you put in the graphs, but they give me some hope. " This made worth having written all those words in chat.
Yes, people different from us, the ones who fight with numbers since the first grade, are the reason that pushes us even today to do something, in our small way: the sister disheartened for having received WhatsApp messages that foresee the apocalypse; the physician friend who sees new sick people every day and asks you "when will it end?"; the ex-student or the old companion of a thousand adventures who will soon see the family grow and cross their fingers so that everything goes well; the mother of someone who no longer turns on the television because everyone says a different thing; who is locked in the house with us; distant friends who keep us company with a message to know how it goes.
We asked ourselves many questions and several others will be asked soon (among which: what is the best combination of interventions to replace the lockdown? what are the signs that we have to start with a new lockdown?); and continue the data hunt more disaggregated and cleaner, to be able to answer even more important questions. We are also doing and planning other things both individually and in groups, including collaborations with clinicians for the study of risk factors, prediction
of prognosis, the optimization of therapy.

Our goals always remain the same: to make ourselves useful with the things we do best.
However, we have a special goal: we already imagine ourselves on the terrace of Gianfranco in Palermo eating arancine, bread and panelle, sfincione and many other healthy things, with a glass of prosecco in hand.

It will take a while  for this to become real, but it is up to each of us to go back to doing what made us feel free.
 Happy Easter to everyone.

Quante parole

StatGroup-19 è nato il 3 Marzo, con la chiamata alle armi di Fabio. 
Non si poteva restare immobili davanti all'epidemia che cominciava, a modelli miracolosi che pretendevano  di salvare l'Italia dal Covid-19 (sembrava una vendita televisiva: "e con il modello vi dò anche due pentole e tre padelle!") e al bisogno reale delle persone di capire cosa sta succedendo.
Dalla nostra  abbiamo l'aver fatto della passione di una vita anche il nostro lavoro. Navigare nel fiumiciattolo dei dati, a volte non proprio puliti, che vengono resi pubblici ogni giorno è il nostro mestiere da anni. Sporcarsi le mani, invece che restare a guardare.
Il nostro lavoro comune è un flusso continuo di pensieri, a volte sconnessi, spesso alle 6 di mattina o alle 2 di notte (l'insonnia è uno dei denominatori comuni che ci tengono insieme). Tutto ha luogo in una caotica chat di Facebook, infilata nella nostra già caotica vita quotidiana  fatta dell'usuale carico di lavoro, tra cui didattica e ricerca. Ci siamo chiesti allora: ma che abbiamo detto in questi giorni?

Qui si può vedere una wordcloud delle parole più frequentemente usate in questi quaranta giorni.
A ieri erano 26116 messaggi e 138245 parole, con i quali abbiamo capito un po' di più della pandemia da covid-19, ci siamo dati qualche risposta, abbiamo condiviso il nostro codice con colleghi del nostro e di altri paesi, e sopratutto speriamo di aver aiutato qualcuno a razionalizzare e ad
avere meno paura. Vicino a parole tipiche della nostra disciplina (dati, modello, poisson, esponenziale..) emerge l'urgenza, la necessità di capire velocemente, lanciare ipotesi, congetture e dubbi e verificarli continuamente sui dati (credo, forse, sembra, capire...); le parole oggi, fare, fatto, così frequenti indicano concretezza e lavoro in tempo reale.


Un'amica di infanzia di uno di noi, qualche settimana fa, scriveva: "non capisco cosa sono quei pallini rossi che mettete nei grafici, ma qualche speranza me la danno." Vale la pena solo per questo aver scritto tutte quelle parole in chat. 
Già, le persone diverse da noi, quelle che con i numeri fanno a botte dalla prima elementare, sono  il motivo che ci spinge anche oggi a fare qualcosa, nel nostro piccolo: la sorella sconfortata per aver ricevuto messaggi whatsapp che prevedono l'apocalisse; l'amico medico che ogni giorno vede nuove persone ammalarsi e ti chiede "quando finirà?"; la ex-studentessa o il vecchio compagno di mille avventure che tra poco vedranno crescere la famiglia e incrociano le dita affinché tutto vada bene; la mamma di qualcuno che non accende più la televisione perché ognuno dice una cosa diversa; chi è chiuso in casa con noi; gli amici lontani che ci fanno compagnia con un messaggio per sapere come va.
Ci siamo posti molte domande e altre diverse ce ne porremo prossimamente (tra le quali: quale è la miglior combinazione di interventi da sostituire al lockdown? quali sono i segnali che bisogna ripartire con un lockdown?); e continuiamo la caccia a dati più disaggregati e più puliti, per poter rispondere ancora ad altre importanti domande.  Sia a livello individuale che di gruppo stiamo anche facendo e progettando altro, tra cui collaborazioni con i clinici per lo studio dei fattori di rischio, la previsione della prognosi, l'ottimizzazione della terapia. 
I nostri obiettivi restano sempre gli stessi: renderci utili con le cose che sappiamo fare meglio.
Abbiamo però un obiettivo speciale: ci immaginiamo già tutti sul terrazzo di Gianfranco a Palermo a mangiare arancine, pane e panelle, sfincione e tante altre cose salutari, con un bicchiere di prosecco in mano.
Ci vorrà ancora un po' affinché questo diventi realtà, ma dipende da ognuno di noi tornare a fare ciò che ci faceva sentire liberi.
 Buona Pasqua a tutti. 

#iorestoacasapuresenonmiva 

sabato 11 aprile 2020

Selection Bias and Mortality data

On the website of the journal Epidemiology and Prevention (https://repo.epiprev.it/) Corrado Magnani and Dario Gregori have inserted a brilliant note on Istat data released on April 1st. It is worth reading it, with a brief introduction. A selection bias (systematic bias) occurs when a subset of the population is over or under-represented in a study.
For example, if I want to study the effectiveness of a therapy, the results of the treatment could be more pronounced in the group of younger people and generally in better health, creating a false response if they are overrepresented compared to the typical patient. Having said that, we report the note on mortality data, observing that these data are however very useful for studies at the municipal level for the municipalities included. Here we propose a rough translation of their contribution:

<< On 1 April ISTAT made available mortality data at the municipal level for the period 1 - 21 March for 1,084 municipalities, without however providing details on the selection criterion. We immediately used this data, confident that there were no other selection criteria other than the operational ones required for the timely availability of information.

The information at the municipal level has been widely used, not only by us, to answer some questions that we consider extremely important, in particular as regards the variation in excess mortality compared to what is officially attributed to the epidemic, also with projections to regional and national level. In the 1084 municipalities of the sample from 1 to 21 March 2020, 16,126 deaths were observed while the expected based on the 2015-2019 average was 7,843.4 deaths. This highlights the importance of being able to use these values ​​to estimate excess mortality at the regional and national levels.
None of this is feasible properly since the sample has been distorted, with a clear selection bias.
The technical document accompanying the data made available on April 9, 2020, relating to the period up to March 28 (www.istat.it/it/files//2020/03/Il_punto_sui_decessi_9_aprile_2020.pdf), which had not been previously disclosed, reports on page 1 in a footnote the following selection criteria: “Municipalities with a number of deaths which, in the period 1 January - 28 March 2020, was greater than or equal to 10 units and which in March 2020 presented, compared to the corresponding average of the 2015-2019 five-year period, an increase in mortality of at least 20% ".

Any epidemiology student knows that selecting only the municipalities that "... have presented ... an increase in mortality of at least 20%" is a serious mistake, which introduces a selection bias. The consequence is to overestimate excess mortality, in an unquantifiable way. Correct data analysis and correct conclusions, therefore, become impossible, particularly if you want to evaluate the overall impact of this period on mortality.

It would be advisable for ISTAT to release a new and complete version of the data without inappropriate selection criteria. >>

Authors of the study:
Corrado Magnani - Unità di Statistica Medica ed Epidemiologia dei Tumori , Dipartimento di Medicina Traslazionale, Università del Piemonte Orientale, Novara
Dario Gregori -  Unità di Biostatistica, Epidemiologia e Sanità Pubblica, Dipartimento di Scienze Cardio-Toraco-Vascolari e Sanità Pubblica, Università di Padova,

Bias di selezione e dati di mortalità

  Sul sito della rivista Epidemiologia e Prevenzione (https://repo.epiprev.it/) Corrado Magnani e Dario Gregori hanno inserito una brillante nota sui dati Istat rilasciati il primo Aprile. Vale la pena leggerla, premettendo una breve introduzione. Un bias (distorsione sistematica) di selezione si verifica quando in uno studio viene sovra o sotto rappresentato un sottogruppo della popolazione.
Ad esempio se voglio studiare l'efficacia di una terapia, i risultati del trattamento potrebbero essere più pronunciati nel gruppo dei più giovani e generalmente in condizioni di salute migliori, creando una risposta falsata se questi sono sovra rappresentati rispetto al paziente tipico. Detto questo riportiamo la nota sui dati di mortalità, osservando che questi dati sono però utilissimi per studi a livello comunale per i comuni inclusi.
<<Il 1′ aprile ISTAT ha dato la disponibilità dei dati di mortalità a livello comunale per il periodo 1 – 21 Marzo per 1.084 comuni, senza però fornire dettagli sul criterio di selezione. Abbiamo subito utilizzato questi dati, confidando che non vi fossero altri criteri di selezione oltre a quelli operativi richiesti per la disponibilità tempestiva dell’informazione.
Le informazioni a livello comunale sono state ampiamente usate, non solo da noi, per rispondere ad alcuni quesiti che riteniamo di estremo rilievo, in particolare per quanto riguarda la variazione della mortalità in eccesso rispetto a quanto attribuito ufficialmente all’epidemia, anche con proiezioni a livello regionale e nazionale. Nei 1084 comuni del campione dal 1 al 21 marzo 2020 si sono osservati 16.126 decessi mentre l’atteso sulla base della media 2015-2019 era di 7.843,4 morti. Da questo si rileva l’importanza di poter usare questi valori per stimare l’eccesso di mortalità a livello regionale e nazionale.
Nulla di tutto questo è fattibile correttamente poiché il campione è stato selezionato in modo distorto, con un chiaro bias di selezione.

Il documento tecnico di accompagnamento ai dati resi disponibili il 9 aprile 2020 relativi al periodo fino al 28 marzo (www.istat.it/it/files//2020/03/Il_punto_sui_decessi_9_aprile_2020.pdf), che non era stato diffuso in precedenza, riferisce a pag. 1 in nota i seguenti criteri di selezione: “Sono stati considerati i comuni con un numero di decessi che, nel periodo 1° gennaio – 28 marzo 2020, è risultato superiore o uguale a 10 unità e che nel mese di marzo del 2020 hanno presentato, rispetto alla corrispondente media del quinquennio 2015 – 2019, un incremento della mortalità pari ad almeno il 20%”.

Qualsiasi studente di epidemiologia rileva selezionare i soli comuni che “… hanno presentato … un incremento della mortalità pari ad almeno il 20%” costituisce un grave errore, che introduce una distorsione di selezione. La conseguenza è di sovrastimare l’eccesso di mortalità, in un modo non quantificabile. Diventano quindi impossibili corrette analisi dei dati e corrette conclusioni, in particolare qualora si voglia valutare l’impatto complessivo di questo periodo sulla mortalità.

Sarebbe opportuno che ISTAT rilasciasse una nuova e completa versione dei dati senza criteri di selezione inopportuni.>>

Autori della nota:
Corrado Magnani - Unità di Statistica Medica ed Epidemiologia dei Tumori , Dipartimento di Medicina Traslazionale, Università del Piemonte Orientale, Novara
Dario Gregori -  Unità di Biostatistica, Epidemiologia e Sanità Pubblica, Dipartimento di Scienze Cardio-Toraco-Vascolari e Sanità Pubblica, Università di Padova,

mercoledì 8 aprile 2020

Riprendiamo con le previsioni in terapia intensiva

Abbiamo deciso di ricominciare
a mostrare le nostre previsioni per i posti occupati in terapia intensiva.
Ci eravamo presi una pausa in quanto abbiamo avuto notizia di molti trasferimenti di pazienti, anche verso l'estero. Pertanto con i dati disponibili non stavamo prevedendo la domanda di accesso, ma solo l'occupazione. Nell'ultima colonna, i posti totali disponibili.
Un documento tecnico può essere trovato al seguente link: 

e la procedura è validata per un orizzonte di cinque giorni.
Ricordiamo che la procedura funziona se il valore reale cade all'interno dell'intervallo. Per molte ragioni, è possibile che per qualche regione questo possa non accadere. Il trend finalmente è decrescente in molte regioni. La pressione sul sistema sanitario si sta allentando.
La speranza rimane comunque quella di sovrastimare sistematicamente.


venerdì 3 aprile 2020

Good, light signals

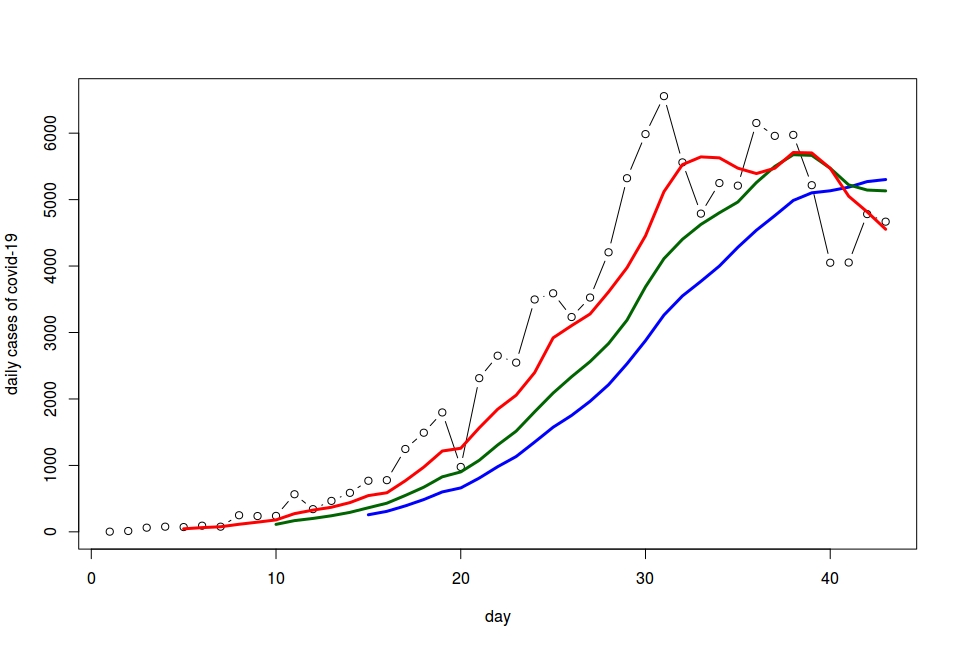
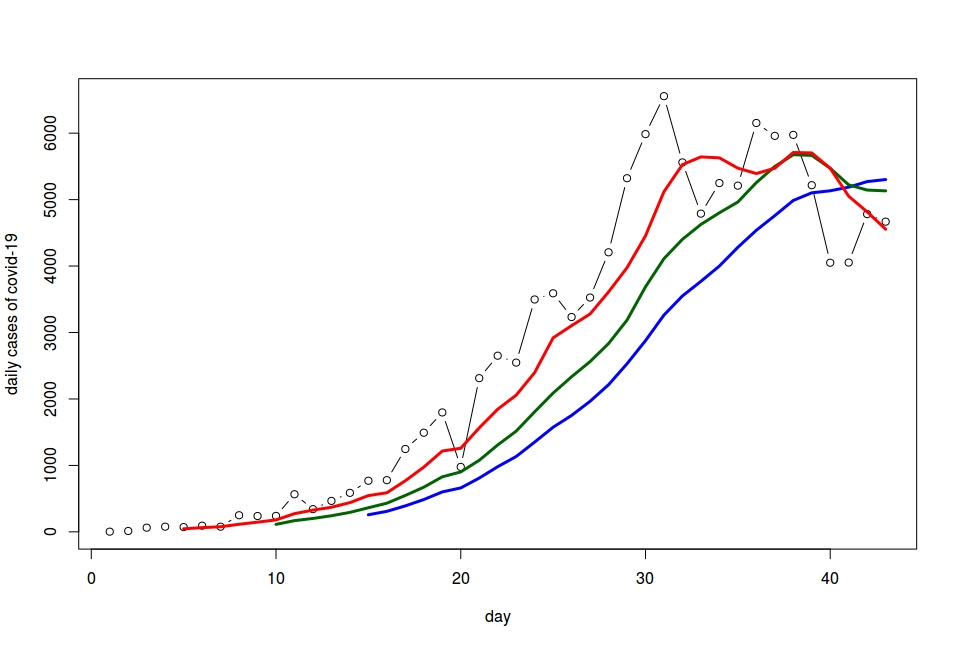
New daily cases of Covid-19, i.e. new daily recorded cases of the disease. The moving average taken over the last 5 days (in red) crosses the moving average over the last 10 days (green). Both, in turn, cross the moving average over the last 15 days (blue) from above. These curve intersections give us some cautious optimism.  
------------------------------
When dealing with time series, moving average analyses can be useful in revealing possible trend changes. Moving averages can – although somewhat simplistically – approximate trends over several time horizons (short, medium, long period) using different lags (measured in days over which the moving average is calculated). For example, a short-term moving average (calculated over the last 5 days) that crosses a long-term moving average (calculated over the last 15 days) from above may be a sign that the until-then increasing trend has now shifted. Caution though. Moving average analyses are generally a tool to confirm results obtained with more sophisticated methods and models.


Buoni, timidi segnali

Nuovi casi giornalieri di #covid19: media mobile sui precedenti 5gg (rosso) che incrocia a scendere la media mobile sui precedenti 10gg (verde) che incrocia a scendere la media mobile sui precedenti 15gg (blue), questi incroci in discesa indicherebbero un cauto segnale di speranza [StatGroup-19]
---
In serie di dati ordinati sul tempo, l'analisi di medie mobile può essere utile per rilevare i potenziali cambiamenti di tendenza. Anche se in modo molto semplice, le medie mobile possono approssimare i vari livelli di trend (breve, medio, lungo periodo) utilizzando ritardi diversi (in termini di giorni su cui la media mobile è calcolata). Ad esempio una media mobile con ritardo breve (calcolata sui precedenti 5gg) che incrocia in discesa una media mobile con ritardo più lungo (calcolata sui precedenti 15gg) potrebbe indicare che una tendenza fino a quel momento crescente ha cambiato direzione. In genere l'analisi di medie mobili si usa solo per confermare in modo semplice analisi effettuate con metodi o modelli più sofisticati.